 好搜
AI智能体走向中小企业:试点扩围,落地仍有门槛
过去一年,企业端关于大模型的讨论焦点,正从“要不要用”转向“怎么用得住”。在多个行业展会和公开报道中可以看到,智能体(Agent)正从演示屏幕走进客服、报销、供应链对账等具体工位。据公开信息,一些SaaS厂商与云服务商已把智能体能力打包进企业服务套餐,试点范围从大型企业向中型企业扩散。但试点扩围并不等于规模化落地,流程改造、数据治理与责任边界,仍是横在企业面前的几道坎。
一、从“演示”到“值班”:应用边界在移动
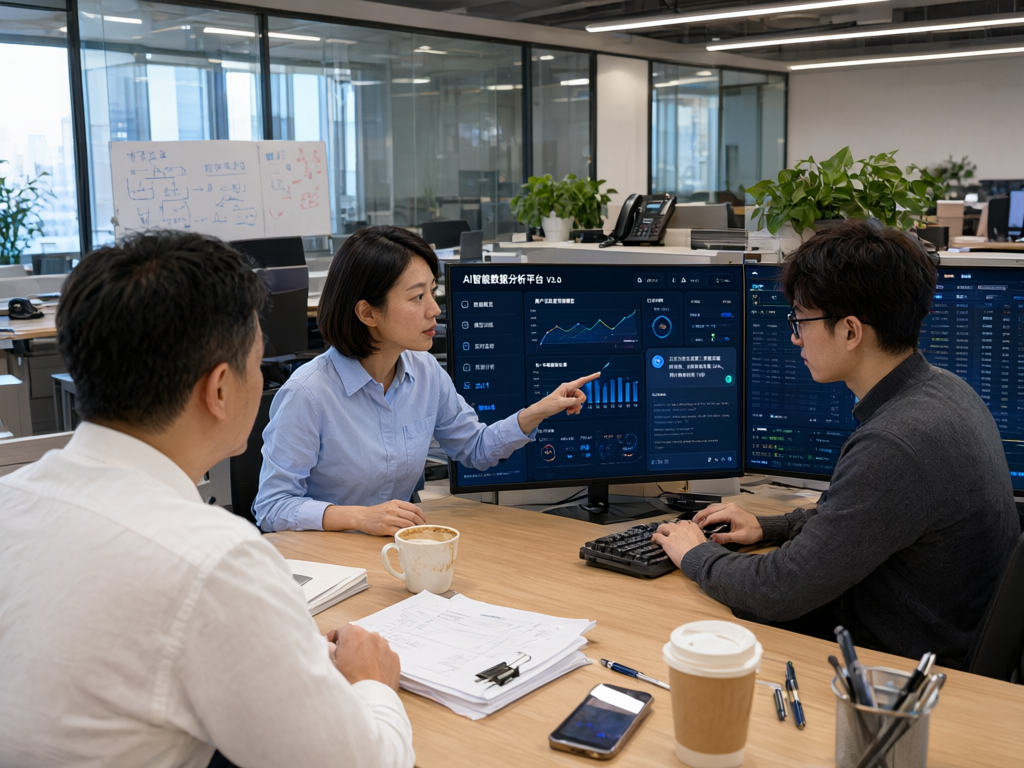
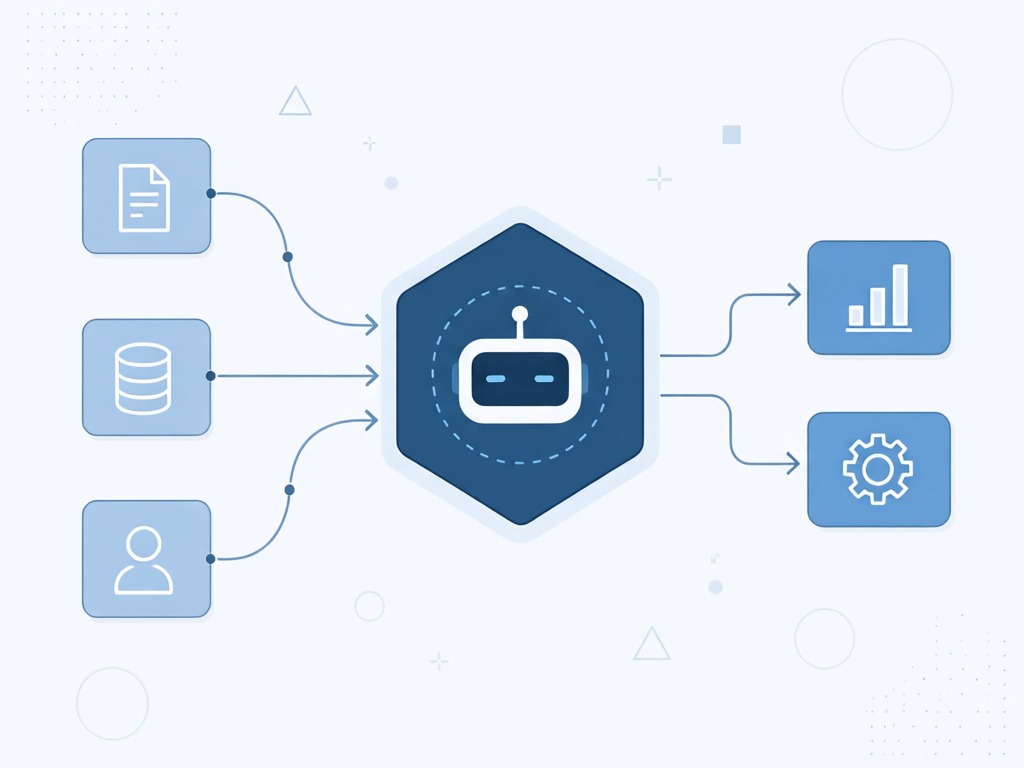
与传统问答式工具不同,智能体的差别在于能够拆解任务、调用工具、连续执行多步操作。客服工单分派、合同要素抽取、报销单据初核、采购询价比价等环节,重复度高、规则相对清晰、结果可被校验,成为首批落点。业内观察认为,这类场景有一个共同特征——“有人兜底、有据可查”。一旦输出出错,业务人员能够快速回溯是哪一步判断偏了。
反过来,涉及定价策略、人事评价、对外承诺、资金审批的环节,多数企业仍然保留人工终审。一位不愿具名的企业信息化负责人表示,内部对智能体的定位更接近“高级实习生”:可以承担草稿和初筛,但不能独立签字。这种谨慎并非保守,而是企业在试错成本与效率收益之间做出的现实权衡。
二、成本曲线下移,约束条件上移
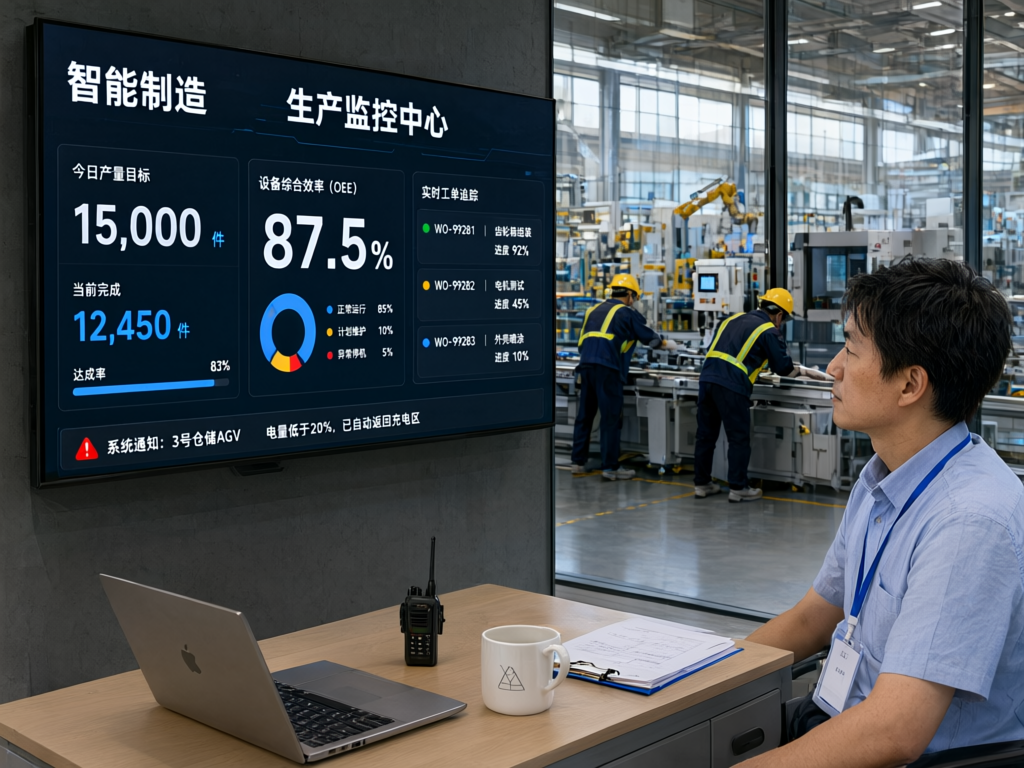
推理成本下降、开源模型成熟,让单次调用的价格较此前明显降低。据公开信息,部分标准化场景的调用成本已降至原来的几分之一甚至更低。但不少企业在复盘时发现,真正的支出大头并不在模型本身,而转向了别处:历史数据清洗、业务系统接口改造,以及把老师傅的经验写成机器可执行的规则。
有服务商反映,在中型企业的项目预算中,“非模型部分”往往占到一半以上。这也解释了一个现象:同样采购了相似的模型能力,有的企业三个月就能跑通闭环,有的半年还在整理数据。差距不在算法,而在数据底座的整洁程度和流程的规范程度。
三、谁来“带”智能体:组织侧的新课题
智能体上线之后,需要有人定义任务边界、检查输出质量、处理异常情况。部分企业新设了“AI运营”类岗位,或由流程负责人兼任。挑战集中在考核方式上:如果只用“节省了多少人力”来衡量,容易忽略错误率与返工成本,形成表面上的效率提升。
更稳妥的做法,是把准确率、人工接管率、单笔处理时长、异常升级路径一并纳入评价体系。换句话说,企业要回答的不只是“它能干多少”,还有“它干错了怎么办”。责任划分清晰,才敢把更重要的环节交给它。
四、中小企业:轻量切入,谨慎扩张
对预算有限的中小企业而言,按场景采购、按调用量付费的模式更为现实。选型时值得关注的几项指标包括:数据能否导出、接口是否开放、出错时责任如何界定、后续维护由谁承担。相比一次性大规模替换,先在单一高频场景跑通、再逐步串联,试错成本更低。
也需要提醒的是,智能体并非万能工具。业务流程本身混乱、数据长期缺失的企业,贸然上马往往只是把旧问题搬到了新系统里。先理流程、再谈工具,仍是绕不开的顺序。
展望未来一段时间,智能体在企业端的推进大概率会沿着“单点深耕—流程串联—跨部门协同”的路径展开,节奏取决于行业属性与数据基础,而非单一技术的迭代速度。企业真正的竞争力,不在于接入了多少个模型,而在于能否把流程说清楚、把数据理干净、把责任划明白。对供给端而言,交付能力与售后响应,可能比参数榜单更能决定谁能长期留在牌桌上。